Model bahasa yang menjadi sangat besar
Sebelum munculnya chatbot AI modern, language model sudah lama menjadi bagian dari penelitian komputasi bahasa.
Tujuan dasarnya adalah memodelkan pola dalam bahasa sehingga sistem dapat memperkirakan kemungkinan bagian bahasa berdasarkan konteks.
Perkembangan kemampuan komputasi, metode training, arsitektur neural network, dan ketersediaan data memungkinkan model bahasa berkembang dalam skala yang jauh lebih besar.
Dari sinilah istilah Large Language Model menjadi populer.
Kata large tidak hanya berkaitan dengan banyaknya data yang digunakan. Model modern juga dapat memiliki jumlah parameter yang sangat besar dan membutuhkan sumber daya komputasi yang signifikan untuk training.
Apa yang dipelajari LLM?
LLM tidak diberi sebuah kamus besar berisi semua kemungkinan pertanyaan dan jawaban.
Model dilatih untuk mempelajari pola dalam data.
Melalui proses tersebut, model dapat mempelajari berbagai keteraturan dalam bahasa, seperti struktur kalimat, hubungan antarkata dan konsep, gaya penulisan, serta pola yang muncul dalam berbagai jenis teks.
Karena bahasa digunakan manusia untuk merepresentasikan banyak pengetahuan tentang dunia, pola yang dipelajari model juga dapat membawa banyak hubungan konseptual.
Tetapi ini tidak berarti LLM memiliki sebuah database sempurna tentang seluruh fakta dunia.
Model bahasa dan database adalah dua hal yang berbeda.
Dari teks menjadi token
Komputer tidak menerima bahasa persis seperti manusia membacanya.
Sebelum diproses oleh model, teks biasanya dipecah menjadi unit-unit yang disebut token.
Kalimat:
“Saya sedang belajar AI.”
dapat direpresentasikan sebagai beberapa token.
Namun satu token tidak selalu berarti satu kata. Cara teks dibagi bergantung pada tokenizer yang digunakan oleh model.
Token tersebut kemudian diubah menjadi representasi numerik sehingga dapat diproses oleh neural network.
Dengan demikian, secara konseptual perjalanan informasi menjadi:
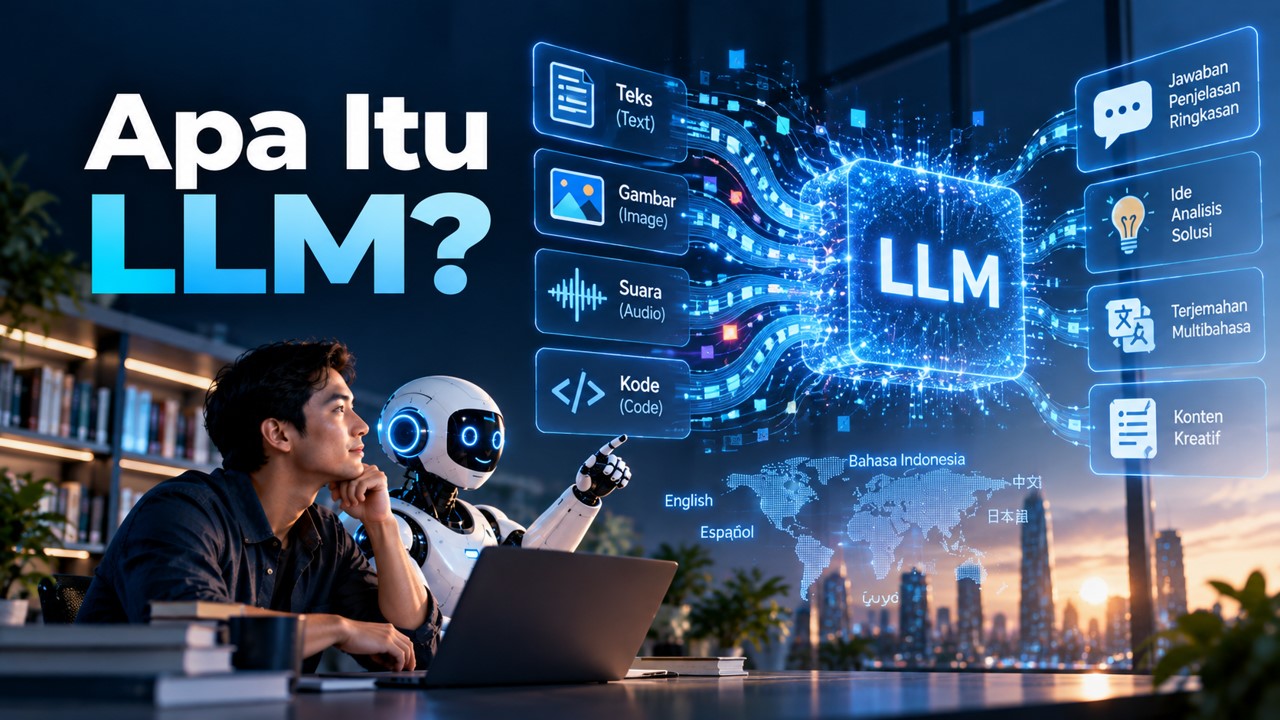
Teks → Token → Representasi numerik → Model → Probabilitas token berikutnya.
Prediksi token berikutnya
Salah satu prinsip dasar banyak LLM adalah next-token prediction.
Model menerima serangkaian token dan memperkirakan distribusi kemungkinan token berikutnya.
Bayangkan prompt:
“Air membeku pada suhu …”
Model menghitung kemungkinan berbagai token yang dapat mengikuti konteks tersebut.
Sebuah token kemudian dipilih berdasarkan proses generasi yang digunakan.
Token itu ditambahkan ke konteks, lalu model kembali memprediksi token berikutnya.
Proses tersebut berlangsung sangat cepat dan berulang hingga terbentuk sebuah respons.
Dengan demikian, jawaban panjang sebenarnya dibangun token demi token.
Mengapa hasilnya bisa terlihat begitu cerdas?
Di sinilah LLM menjadi menarik.
Prediksi token berikutnya terdengar seperti tugas sederhana. Tetapi bahasa manusia mengandung struktur yang sangat kompleks.
Untuk memprediksi kelanjutan teks dengan baik, model dapat memperoleh representasi yang berguna tentang banyak pola: tata bahasa, hubungan konsep, struktur argumen, format dokumen, pola pemrograman, serta banyak keteraturan lainnya.
Ketika skala model, data, dan training meningkat, model dapat menunjukkan kemampuan yang tidak selalu terlihat pada sistem yang lebih kecil.
Akibatnya, LLM dapat melakukan banyak tugas hanya dengan menerima instruksi dalam bahasa biasa.
Transformer
Kemajuan LLM modern sangat berkaitan dengan arsitektur Transformer, yang diperkenalkan dalam penelitian pada 2017.
Transformer memungkinkan model memproses hubungan antara bagian-bagian dalam suatu urutan secara efektif.
Salah satu konsep penting di dalamnya adalah attention.
Secara sederhana, attention membantu model menentukan bagian mana dari konteks yang relevan ketika memproses suatu token.
Misalnya dalam kalimat panjang, sebuah kata di bagian akhir mungkin berhubungan dengan informasi yang muncul jauh sebelumnya.
Mekanisme attention membantu model menggunakan hubungan tersebut ketika membangun representasi konteks.
Context window
LLM tidak selalu mempertimbangkan seluruh informasi yang pernah ada.
Setiap model memiliki batas jumlah token yang dapat diproses dalam suatu konteks pada satu waktu, yang sering disebut context window.
Isi context window dapat mencakup prompt pengguna, instruksi sistem, bagian percakapan sebelumnya, dokumen yang diberikan, atau informasi lain yang dimasukkan ke konteks.
Semakin besar context window, semakin banyak informasi yang secara teknis dapat diberikan kepada model dalam satu proses.
Namun context window besar tidak otomatis menjamin bahwa setiap detail akan digunakan dengan sempurna.
Training dan penggunaan sehari-hari berbeda
Seperti yang kita bahas pada Lite sebelumnya, ada perbedaan antara training dan inference.
Training adalah proses ketika parameter model dipelajari atau disesuaikan.
Inference adalah proses menggunakan model tersebut untuk menghasilkan keluaran.
Ketika Anda mengetik pertanyaan kepada sebuah chatbot berbasis LLM, model biasanya sedang melakukan inference terhadap konteks yang diberikan.
Ini berbeda dari proses training besar yang sebelumnya membentuk parameter model.
LLM dapat disempurnakan setelah pretraining
Model dasar yang telah melalui pretraining belum tentu langsung menjadi asisten yang nyaman digunakan.
Pengembang dapat menggunakan berbagai proses tambahan untuk membantu model mengikuti instruksi, menghasilkan respons yang lebih berguna, atau menyesuaikan perilakunya.
Tekniknya dapat berbeda antara satu sistem dengan sistem lain dan terus berkembang.
Karena itu chatbot yang kita gunakan sehari-hari biasanya bukan sekadar model mentah + kotak percakapan.
Ada lapisan lain seperti instruksi, penyelarasan model, sistem keselamatan, retrieval, tools, memory atau konteks tambahan, dan aplikasi yang membungkus model tersebut.
LLM bukan mesin pencari
Ini perbedaan yang sangat penting.
Mesin pencari pada dasarnya membantu menemukan dokumen atau halaman yang dianggap relevan dari sebuah indeks.
LLM menghasilkan keluaran melalui model.
Karena itu ketika LLM menjawab sebuah pertanyaan, kita tidak boleh otomatis menganggap jawabannya berasal dari satu halaman tertentu yang baru saja ditemukan di internet.
Beberapa sistem AI memang dapat digabungkan dengan search, database, dokumen, atau sistem retrieval.
Dalam keadaan tersebut, LLM dapat menggunakan informasi eksternal yang diberikan kepadanya.
Tetapi itu merupakan sistem gabungan.
LLM itu sendiri bukan internet.
LLM juga bukan database fakta
Parameter model menyimpan pola yang diperoleh melalui training, bukan tabel fakta yang selalu dapat dipanggil kembali secara sempurna.
Karena itu LLM dapat mengetahui banyak hal tetapi tetap melakukan kesalahan pada fakta yang terlihat sederhana.
Ia juga dapat menghasilkan informasi yang tampak masuk akal padahal tidak memiliki dasar yang benar.
Kemampuan menghasilkan bahasa yang lancar dapat membuat kesalahan tersebut sulit dikenali.
Temperature dan variasi jawaban
Pada proses generasi, sistem dapat menggunakan pengaturan yang memengaruhi bagaimana token dipilih dari distribusi probabilitas.
Salah satu istilah yang sering ditemui adalah temperature.
Secara umum, konfigurasi tertentu dapat membuat keluaran lebih konsisten, sementara konfigurasi lain dapat memberikan variasi yang lebih besar.
Karena proses generasi dapat melibatkan pemilihan probabilistik, prompt yang sama tidak selalu harus menghasilkan kalimat yang identik.
Mengapa prompt berpengaruh?
LLM menghasilkan keluaran berdasarkan konteks.
Karena itu cara pengguna memberikan instruksi dapat memengaruhi hasil.
Prompt yang menjelaskan tujuan, konteks, batasan, format keluaran, dan informasi yang relevan sering memberikan model kondisi yang lebih baik untuk menghasilkan respons yang sesuai.
Namun prompt yang bagus tidak menjamin jawaban benar.
Jika model tidak memiliki informasi yang memadai atau menghasilkan pola yang keliru, jawaban tetap dapat salah.
Dari LLM menuju sistem AI
Dalam aplikasi modern, LLM semakin sering menjadi salah satu komponen dari sistem yang lebih besar.
Model dapat dihubungkan dengan:
- mesin pencari,
- database,
- dokumen internal,
- kalkulator,
- interpreter kode,
- API,
- aplikasi perusahaan,
- atau berbagai tools lainnya.
Dalam sistem seperti ini, LLM tidak harus mengandalkan parameternya sendiri untuk setiap tugas.
Ia dapat menggunakan sumber informasi atau alat eksternal untuk membantu menyelesaikan pekerjaan.
Karena itu penting membedakan:
LLM sebagai model
dan
produk AI sebagai keseluruhan sistem.
Chatbot yang terlihat sederhana di layar dapat memiliki banyak komponen di belakangnya.
Lalu mengapa LLM bisa salah?
Sekarang kita sampai pada salah satu sifat LLM yang paling penting untuk dipahami.
Tujuan dasar proses generasi bahasa adalah menghasilkan kelanjutan yang sesuai dengan pola dan konteks.
Model tidak memiliki mekanisme universal yang menjamin setiap token yang dihasilkan merupakan fakta yang benar.
Akibatnya, model dapat menghasilkan nama, angka, kutipan, referensi, atau penjelasan yang terdengar sangat masuk akal tetapi ternyata keliru.
Fenomena inilah yang sering disebut:
AI hallucination.
Dan itu membawa kita langsung ke Lite berikutnya.