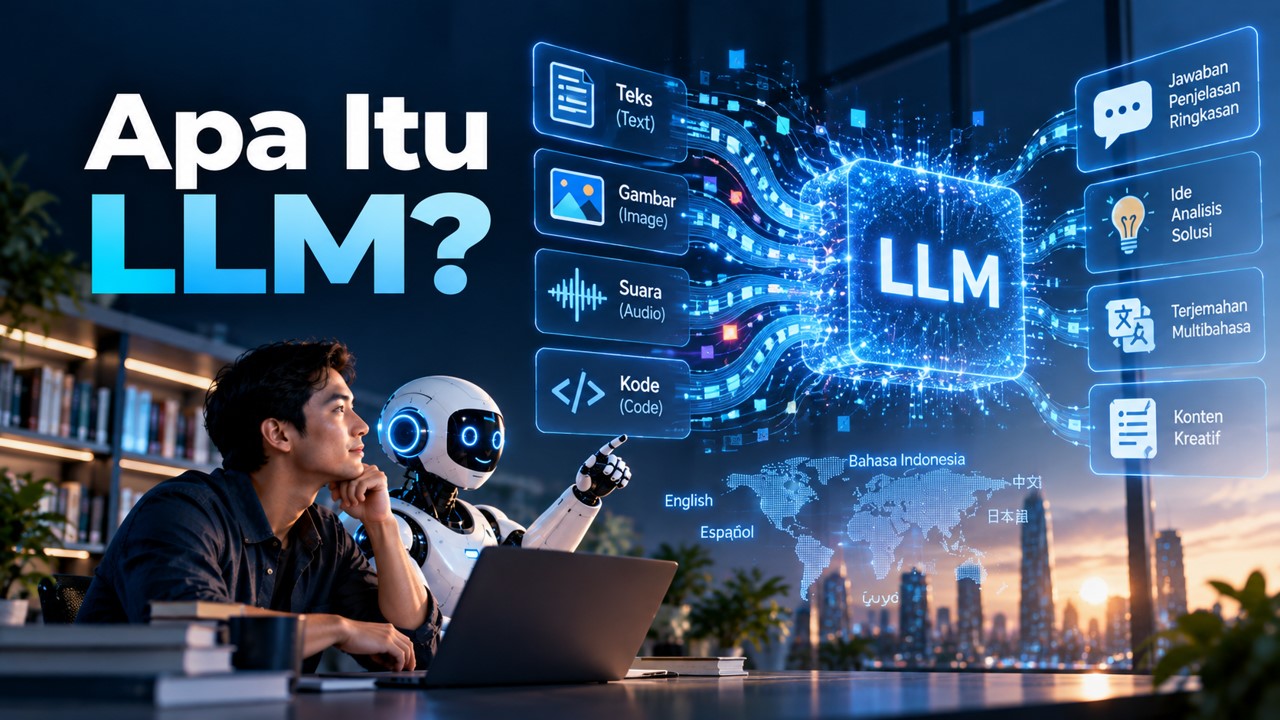
Large Language Model (LLM) adalah jenis model AI yang dirancang untuk memproses dan menghasilkan bahasa.
LLM belajar dari data teks dalam skala besar. Selama training, model mempelajari pola tentang bagaimana bagian-bagian bahasa saling berhubungan dalam berbagai konteks.
Teks yang diproses model terlebih dahulu direpresentasikan sebagai unit yang disebut token.
Token tidak selalu sama dengan satu kata. Sebuah token dapat berupa sebuah kata, bagian dari kata, tanda baca, atau unit lain tergantung sistem tokenisasi yang digunakan.
Misalnya, ketika kita memberikan prompt:
“Ibu kota Indonesia adalah …”
model menggunakan konteks tersebut untuk memperkirakan token yang kemungkinan sesuai berikutnya.
Setelah sebuah token dihasilkan, proses tersebut diulang:
Konteks → prediksi token → tambahkan token → prediksi lagi → ulangi.
Dari proses berulang inilah sebuah jawaban dapat terbentuk.
LLM modern biasanya menggunakan arsitektur neural network yang disebut Transformer. Salah satu komponen pentingnya adalah mekanisme attention, yang membantu model mempertimbangkan hubungan antara bagian-bagian informasi dalam konteks yang sedang diproses.
Ketika model, data, komputasi, training, dan teknik penyelarasan berkembang, muncul kemampuan yang jauh lebih luas daripada sekadar menyelesaikan kalimat.
LLM dapat membantu:
- menjawab pertanyaan,
- membuat ringkasan,
- menerjemahkan,
- menulis dan menjelaskan kode,
- mengklasifikasikan informasi,
- mengolah dokumen,
- serta menghasilkan berbagai bentuk teks.
Tetapi ada batas penting.
LLM menghasilkan respons berdasarkan pola dan konteks. Ia tidak otomatis memeriksa apakah setiap pernyataan yang dihasilkannya benar di dunia nyata.
Karena itu, keluaran yang terdengar sangat meyakinkan tetap perlu diverifikasi ketika akurasi faktual penting.