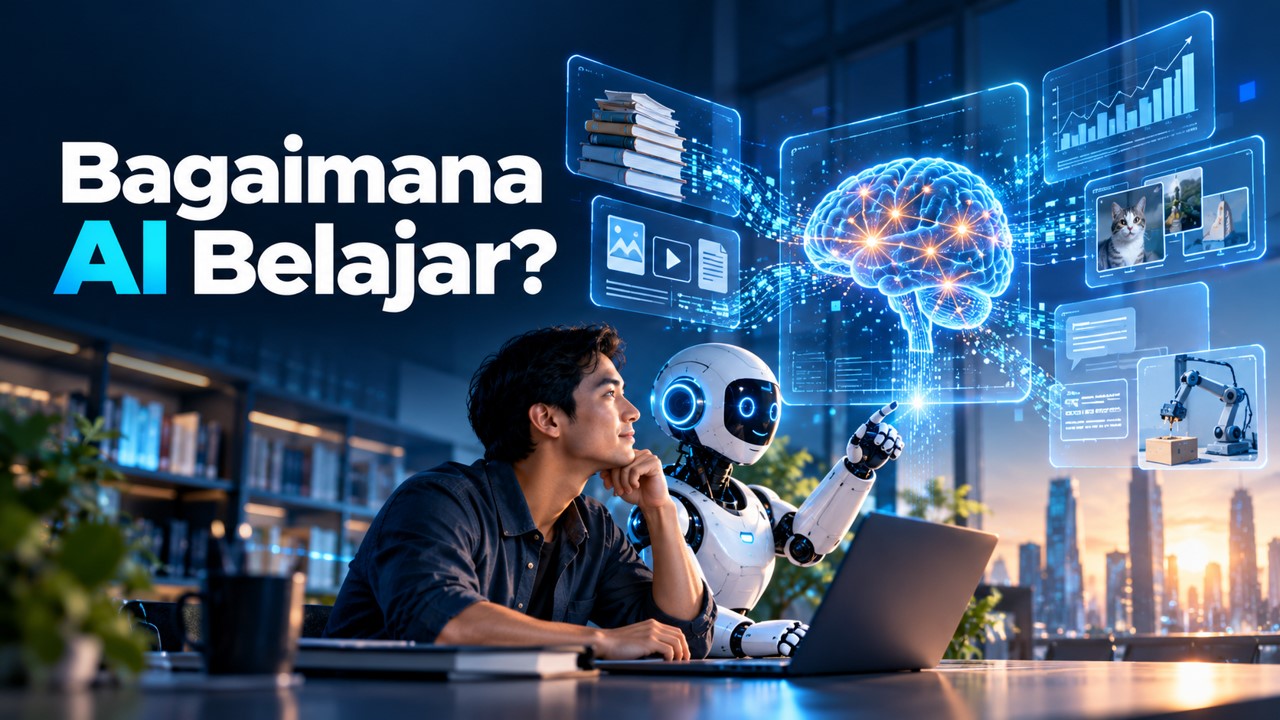
Apa yang dimaksud dengan “belajar”?
Ketika manusia belajar, kita dapat membaca, mencoba sesuatu, bertanya, menghubungkan pengalaman baru dengan pengalaman lama, dan memahami konteks kehidupan.
AI bekerja dengan mekanisme yang berbeda.
Dalam machine learning, “belajar” umumnya berarti menyesuaikan parameter sebuah model agar dapat menghasilkan keluaran yang semakin sesuai dengan tujuan tertentu berdasarkan data atau pengalaman komputasional yang diberikan kepadanya.
Model tersebut pada dasarnya merupakan sistem matematis.
Ia menerima input, melakukan serangkaian perhitungan, kemudian menghasilkan output.
Training adalah proses untuk menemukan konfigurasi parameter yang membuat model bekerja lebih baik.
Data sebagai bahan belajar
Data merupakan salah satu bahan utama dalam banyak sistem AI.
Data dapat berupa:
- teks,
- gambar,
- suara,
- video,
- angka,
- data sensor,
- transaksi,
- atau bentuk informasi digital lainnya.
Jenis data yang digunakan bergantung pada tujuan sistem.
Model pengenal gambar membutuhkan data visual. Sistem pengenal suara membutuhkan rekaman audio. Model bahasa belajar dari data bahasa dalam skala besar.
Tetapi banyak data tidak otomatis berarti AI yang baik.
Kualitas, keragaman, relevansi, representasi, serta proses pengolahan data juga sangat penting.
Jika data mengandung kesalahan atau bias tertentu, model dapat ikut mempelajari pola tersebut.
Training: ketika model mulai menyesuaikan diri
Bayangkan sebuah model yang harus memprediksi apakah sebuah gambar menunjukkan kucing.
Pada awalnya, parameter model belum disesuaikan dengan baik. Prediksinya mungkin buruk.
Model menerima gambar sebagai input dan menghasilkan prediksi.
Misalnya:
Prediksi model: 30% kemungkinan kucing.
Padahal targetnya adalah kucing.
Sistem kemudian menggunakan fungsi matematis untuk mengukur kesalahan atau loss antara hasil prediksi dengan tujuan pembelajaran.
Setelah itu, algoritma optimasi menyesuaikan parameter model agar kesalahan tersebut cenderung berkurang.
Proses ini dilakukan berulang kali.
Secara konseptual:
Data → Model → Prediksi → Loss → Penyesuaian parameter → Ulangi
Pada jaringan saraf modern, jumlah parameter dapat sangat besar sehingga proses training membutuhkan kemampuan komputasi yang signifikan.
Apa sebenarnya yang dipelajari?
Model tidak menyimpan sebuah buku aturan manusia seperti:
Jika telinganya seperti ini dan kumisnya seperti itu, berarti kucing.
Sebaliknya, model membentuk representasi matematis berdasarkan pola yang ditemukan selama training.
Pada sistem yang kompleks, pola tersebut dapat memiliki banyak tingkatan.
Dalam pengenalan gambar, misalnya, lapisan tertentu dapat menjadi sensitif terhadap bentuk sederhana, tekstur, atau struktur visual, sementara representasi yang lebih dalam dapat menggabungkan informasi tersebut menjadi pola yang lebih kompleks.
Pada model bahasa, pola yang dipelajari berhubungan dengan bahasa: bagaimana token dan konsep muncul dalam konteks, bagaimana struktur bahasa terbentuk, serta berbagai hubungan statistik dalam data pelatihan.
Tiga cara belajar yang sering dibahas
1. Supervised Learning
Dalam supervised learning, model memperoleh contoh beserta target atau label.
Contohnya:
gambar → kucing
gambar → anjing
Model membuat prediksi kemudian membandingkannya dengan target.
Metode ini banyak digunakan dalam klasifikasi dan prediksi.
2. Unsupervised Learning
Dalam unsupervised learning, data tidak selalu disertai label jawaban yang eksplisit.
Sistem mencoba menemukan struktur atau pola dalam data.
Salah satu contoh sederhananya adalah mengelompokkan data berdasarkan kemiripan tertentu.
3. Reinforcement Learning
Dalam reinforcement learning, sebuah agen berinteraksi dengan lingkungan dan menerima sinyal berupa reward berdasarkan tindakannya.
Tujuannya adalah mempelajari strategi yang menghasilkan reward kumulatif yang baik.
Pendekatan ini digunakan antara lain dalam permainan, robotika, pengambilan keputusan, dan juga sebagai salah satu teknik dalam pengembangan beberapa sistem AI modern.
Training berbeda dengan inference
Ini adalah perbedaan penting.
Training adalah proses ketika model belajar atau menyesuaikan parameternya.
Inference adalah proses ketika model yang sudah dilatih digunakan untuk menghasilkan prediksi atau keluaran.
Ketika sebuah chatbot AI menjawab pertanyaan Anda, pada umumnya Anda sedang berinteraksi dengan proses inference, bukan menyaksikan model melakukan training dasar dari awal.
Model menggunakan parameter yang telah diperoleh sebelumnya untuk memproses input dan menghasilkan respons.
Apakah AI menghafal?
Jawabannya tidak sesederhana ya atau tidak.
Model machine learning dirancang untuk mempelajari pola yang dapat digunakan pada data baru. Namun model yang besar juga dapat, dalam kondisi tertentu, mengingat atau mereproduksi bagian tertentu dari data pelatihannya.
Karena itu para peneliti memperhatikan perbedaan antara generalization dan memorization.
Model yang hanya menghafal data training tetapi gagal menangani situasi baru tidak memiliki kemampuan generalisasi yang baik.
Salah satu masalah yang dikenal dalam machine learning adalah overfitting: model terlalu menyesuaikan diri dengan data training sehingga performanya menurun ketika menghadapi data baru.
Mengapa kualitas data penting?
AI belajar dari pola yang tersedia dalam data dan sinyal pembelajarannya.
Artinya, data yang tidak representatif dapat menghasilkan sistem yang bekerja tidak merata pada kondisi atau kelompok tertentu.
Kesalahan dalam data juga dapat memengaruhi model.
Karena itu pembangunan AI tidak hanya berkaitan dengan algoritma.
Ada pertanyaan penting tentang:
- dari mana data berasal,
- bagaimana data dikumpulkan,
- bagaimana kualitasnya diperiksa,
- apakah data cukup representatif,
- bagaimana privasi dilindungi,
- dan bagaimana performa model dievaluasi.
Belajar bukan berarti memahami seperti manusia
Inilah salah satu perbedaan yang mudah terlupakan.
Sebuah AI dapat mempelajari pola yang sangat kompleks dan menghasilkan keluaran yang mengesankan.
Tetapi keberhasilan melakukan suatu tugas tidak otomatis membuktikan bahwa AI memiliki pengalaman atau pemahaman manusia terhadap apa yang sedang dilakukannya.
Model bahasa, misalnya, dapat menghasilkan penjelasan yang terdengar sangat meyakinkan.
Namun keluaran tersebut tetap dihasilkan melalui proses komputasi berdasarkan model, konteks input, dan pola yang telah dipelajari.
Karena itulah AI terkadang dapat menghasilkan jawaban yang terdengar benar tetapi ternyata salah.
Untuk memahami mengapa hal tersebut dapat terjadi, kita perlu masuk lebih jauh ke salah satu teknologi yang berada di balik banyak chatbot AI modern:
Large Language Model atau LLM.